查询分析
"搜索" 支撑着许多用例——包括检索增强生成中的 "检索" 部分。最简单的做法是将用户问题直接传递给检索器。为了提高性能,你还可以通过 查询分析 以某种方式 "优化" 查询。这在传统上是通过基于规则的技术完成的,但随着 LLM 的兴起,使用 LLM 来做这件事正变得越来越流行、越来越可行。具体来说,这涉及将原始问题(或消息列表)传入 LLM,并返回一个或多个优化后的查询,这些查询通常包含一个字符串以及可选的其他结构化信息。
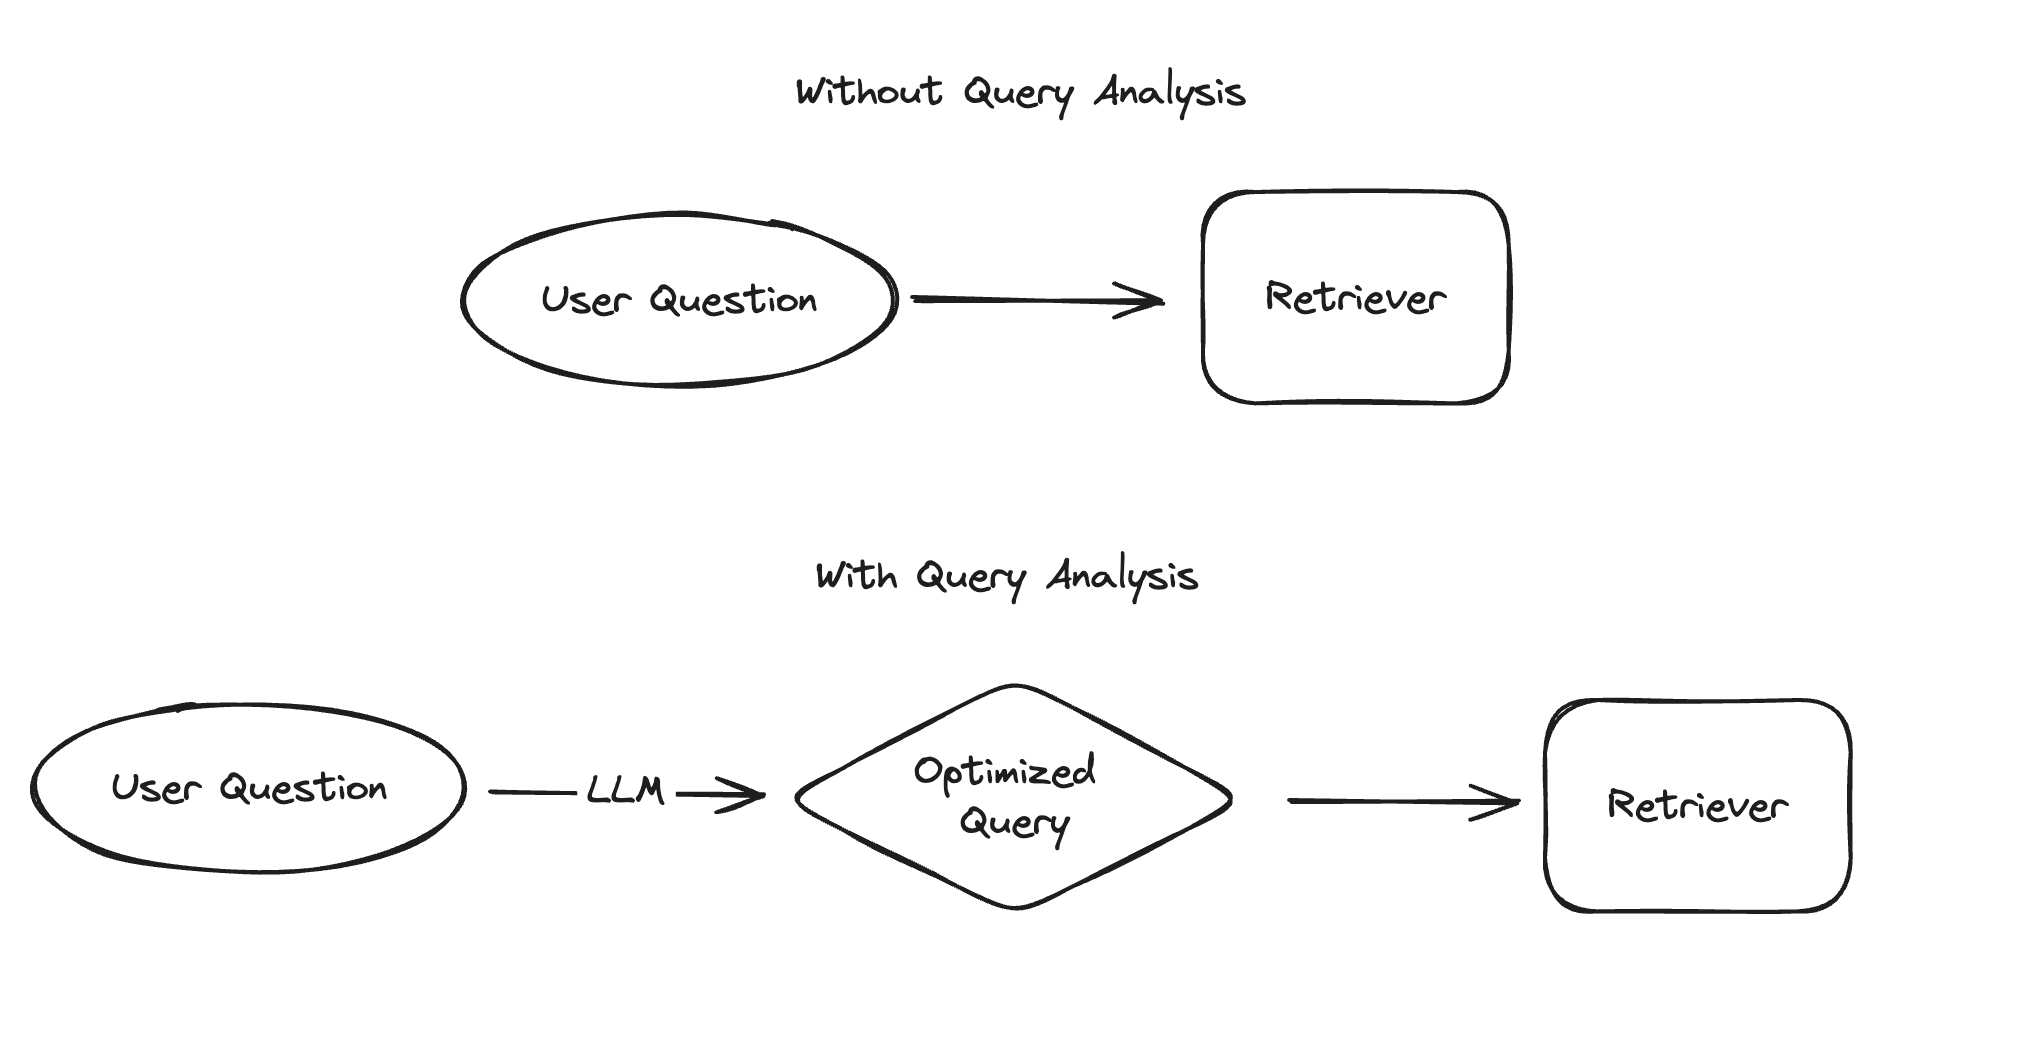
解决的问题
查询分析有助于优化发送给检索器的搜索查询。以下情况尤其如此:
- 检索器支持针对数据特定字段的搜索和过滤,而用户输入可能指代其中任何一个字段,
- 用户输入中包含多个不同的提问,
- 为了检索相关信息需要多个查询,
- 搜索质量对措辞敏感,
- 有多个检索器可以搜索,而用户输入可能指代其中任何一个。
请注意,不同的问题需要不同的解决方案。为了确定应该使用哪种查询分析技术,你需要准确理解当前检索系统的问题所在。最好的方法是查看当前应用的失败数据点,并识别共同的主题。只有知道了问题所在,你才能开始解决它们。
快速开始
前往 快速开始,了解如何在一个基本的端到端示例中使用查询分析。它将涵盖在 LangChain YouTube 视频内容上创建一个搜索引擎,展示将原始用户问题传递给该索引时出现的失败模式,然后给出一个查询分析如何帮助解决该问题的示例。该快速开始侧重 查询结构化。以下是根据你的数据和用例可能相关的其他查询分析技术。
技术
我们支持多种从原始问题或消息列表得到更优化查询的技术,包括:
- 查询分解:如果用户输入包含多个不同的提问,我们可以将输入分解为多个将独立执行的查询。
- 查询扩展:如果索引对查询措辞敏感,我们可以生成用户问题的多个改写版本,以增加检索到相关结果的机会。
- 假设文档嵌入(HyDE):如果我们处理的是基于相似度搜索的索引,例如向量存储,那么直接搜索原始问题可能效果不佳,因为它们的嵌入可能与相关文档的嵌入不太相似。相反,让模型生成一个假设的相关文档,然后用它来执行相似度搜索可能更有帮助。
- 查询路由:如果我们有多个索引,而只有其中一个子集对任何给定用户输入有用,我们可以将输入路由到只从相关的索引中检索结果。
- 回退提示:有时搜索质量和模型生成会被问题的具体细节绊倒。处理这种情况的一种方法是先生成一个更抽象、"回退" 的问题,然后基于原始问题和回退问题两者进行查询。
- 查询结构化:如果我们的文档有多个可搜索/可过滤的属性,我们可以从任何原始用户问题中推断出应该对哪些特定属性进行搜索/过滤。例如,当用户输入具体提到视频发布日期时,这应该变成对每个文档
publish_date属性的过滤。